Claude Code 1M 上下文之后,真正重要的是如何管理 Session
最近 Claude Code 发布了一个新的功能:/usage。这个命令可以帮助用户更清楚地了解自己在 Claude Code 中的使用情况。
但在 Anthropic 与用户交流的过程中,一个反复出现的问题是:不同用户管理 session 的方式差异非常大,尤其是在 Claude Code 更新到 100 万 token 上下文之后。
有的人习惯一直使用同一个 session,把所有任务都放进去; 有的人每一个 prompt 都开启一个新 session; 也有人不确定什么时候该使用 /compact、/clear、/rewind 或 subagents。
这其实引出了一个更核心的问题:
上下文越大,并不代表使用效果一定越好。
Claude Code 的 1M context 确实让 AI 编程工具进入了一个新的阶段。它可以读取更多文件,处理更复杂的任务,也更适合长链路开发、跨模块重构和大型项目理解。
但上下文变大之后,另一个问题也会变得更明显:
如果不管理上下文,AI 反而可能越来越不稳定。
一、什么是上下文?
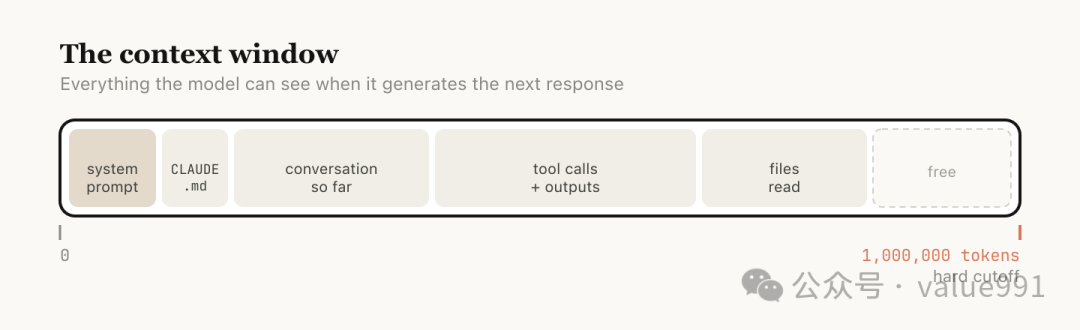
简单理解,上下文就是模型当前能够“看到”的所有内容。
在 Claude Code 中,上下文包括:
你和 Claude 的对话、系统提示词、已经读取过的文件、工具调用结果、终端输出、错误日志,以及之前所有的修改过程。
这也是 Claude Code 能够连续工作的基础。
比如你让它先读代码,再分析问题,再修改文件,再运行测试,它之所以能接着往下做,是因为这些信息都还在上下文里。
但问题是:
上下文不是越多越好。
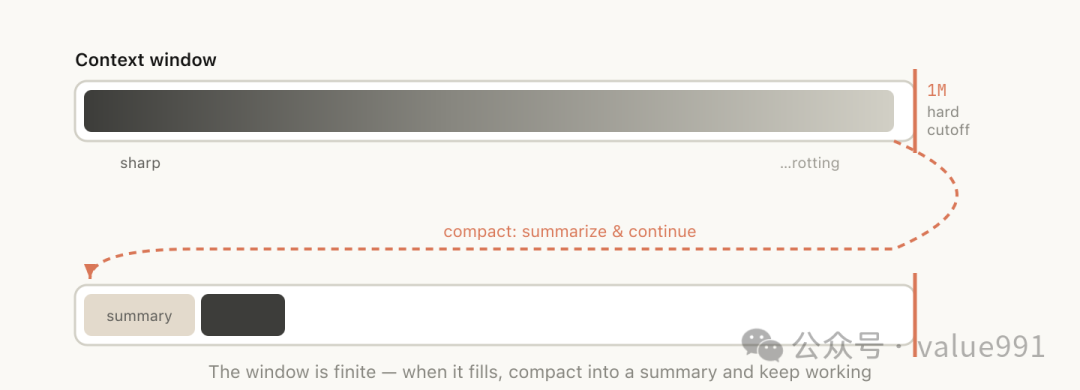
当上下文越来越长,里面会混入很多已经失效的信息,例如:
调试过程中走过的错误方向; 已经被否定的实现方案; 临时性的错误日志; 和当前任务无关的历史讨论; 上一阶段任务留下来的噪音。
这些内容都会影响模型下一步的判断。
这就是文章中提到的 context rot,也可以理解为“上下文腐烂”。
二、1M context 不是让你一直不开新 session
很多人看到 100 万 token 上下文后,会自然认为:
既然上下文这么大,那是不是可以一直用一个 session?
答案是:不建议。
1M context 的价值,不是让你把所有事情都塞进同一个 session,而是让你在处理复杂任务时有更大的空间。
比如:
从零构建一个完整功能; 理解一个大型代码库; 进行跨文件重构; 连续分析多个错误日志; 在同一个模块内完成设计、实现和测试。
这些场景适合长上下文。
但是,如果你已经从一个任务切换到另一个任务,就应该考虑开启新的 session。
一个简单原则是:
新任务,新 session。
比如:
刚刚完成登录模块,现在要优化官网首页,建议新开 session。 刚刚完成代码实现,现在要写公众号文章,建议新开 session。 刚刚排查完测试问题,现在要设计新的产品页面,建议新开 session。
因为这些任务之间并不需要共享全部上下文。
继续沿用旧 session,只会把无关信息带进来,让 Claude 更容易判断偏航。
三、不要把 session 当成永久记忆
Claude Code 的 session 很像一个临时工作台。
它适合承载当前任务,但不适合承载所有长期知识。
真正重要的信息,不应该只留在聊天上下文里,而应该沉淀到项目文件中。
例如:
CLAUDE.md README.md docs/task-brief.md docs/implementation-notes.md docs/review-checklist.md
如果你希望 Claude Code 长期遵守某些规则,比如项目结构、代码规范、设计原则、命名习惯、禁止修改的文件、测试方式,就应该写进文档,而不是每次都靠聊天补充。
因为 session 会结束,compact 会丢信息,新 session 也不会自动继承旧 session 的全部内容。
上下文是临时的,文档才是可复用的。
四、什么时候继续当前 session?
并不是所有情况都要新开 session。
如果当前任务还没有结束,并且下一步强依赖之前的信息,就应该继续当前 session。
比如:
Claude 刚读完一批文件,你要它继续修改这些文件; 它刚分析完一个 bug,你要它直接实现修复; 它刚生成了一个页面结构,你要它继续优化样式; 它刚完成一轮代码修改,你要它继续运行测试并修复报错。
这些情况下,继续当前 session 是合理的。
因为旧上下文仍然有价值。
但是,如果你发现自己已经开始说:
“顺便再帮我看另一个问题。” “另外一个模块也改一下。” “现在我们换个话题。”
这通常就是应该新开 session 的信号。
五、什么时候使用 /rewind?
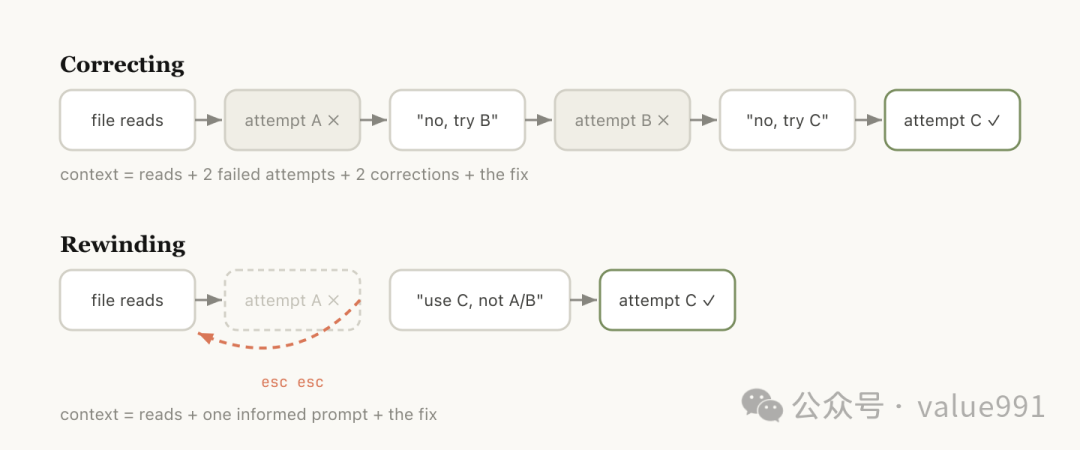
很多人纠正 AI 的方式是直接说:
“你刚才错了,重新来。”
但这不一定是最好的做法。
因为错误路径仍然留在上下文中。
Claude 可能已经读取了很多文件、尝试了一个错误方案、产生了一堆失败输出。如果你只是继续追加纠正,这些错误信息仍然会影响后续判断。
Claude Code 里的 /rewind,就是为这种情况准备的。
它可以让你回到之前的某个节点,从那里重新开始。后面的错误路径会被移除。
例如:
Claude 读取完文件后,选择了错误的实现方式。 这时不要继续说“这个方案不行”。 更好的方式是 rewind 到读取文件之后,然后重新提示:
不要使用方案 A。刚才验证过,foo 模块不支持这个能力。请直接使用方案 B。
这样,Claude 可以保留前面有价值的文件阅读结果,同时丢掉后面错误的执行路径。
走错方向时,不要一直修补错误上下文,应该回到分叉点重新选择。
六、什么时候使用 /compact?
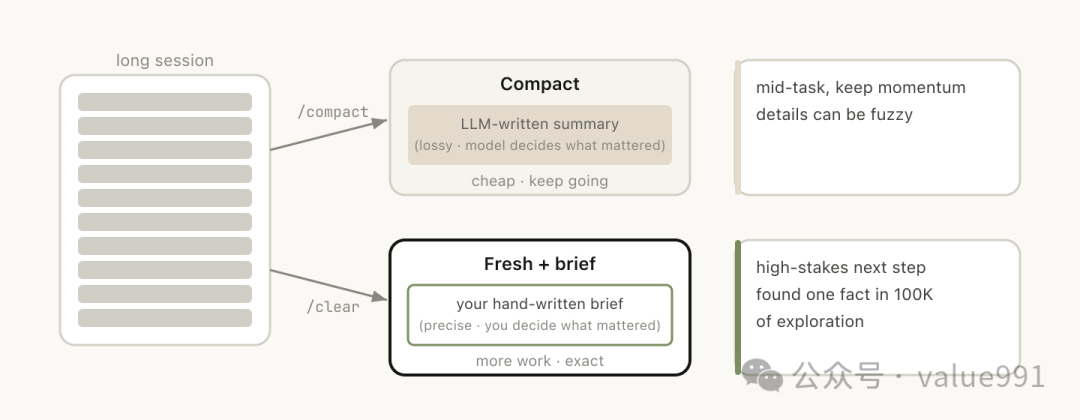
当一个 session 变得很长,但你还想继续这个任务时,可以使用 /compact。
它的作用是把当前 session 总结成一段更短的摘要,然后基于摘要继续工作。
这适合以下场景:
当前任务还没结束; 上下文已经比较长; 前面有一些重要结论需要保留; 但大量中间过程不再需要。
例如你做了很长时间的调试,现在已经确认问题原因,下一步要进入修复阶段。
这个时候可以主动 compact,而不是等系统自动 compact。
更好的做法是给 compact 加上明确指令:
/compact 保留问题原因、关键文件、已排除的方案和下一步修复计划,丢弃临时日志和无关测试输出。
这样比自动 compact 更可靠。
因为自动 compact 最大的问题是:模型不一定知道你下一步要做什么。
它可能会把后面真正需要的信息当成不重要内容丢掉。
所以,compact 最好主动做,并且告诉 Claude 保留什么、丢掉什么。
七、什么时候使用 /clear?
/clear 适合在你想彻底重新开始的时候使用。
它和 /compact 不一样。
/compact 是让 Claude 帮你总结当前上下文。 /clear 是你自己决定哪些信息要带入新 session。
如果当前 session 已经很混乱,或者任务已经切换,使用 /clear 更合适。
你可以自己写一个简短 brief:
我们现在要重构 auth middleware。 背景: - 当前问题是登录状态校验逻辑分散 - 目标是统一到 auth middleware - 相关文件是 A、B、C - 已经排除方案 X - 不要修改 legacy login flow - 下一步请先阅读相关文件并给出修改计划
这种方式比让模型自动总结更可控。
当你已经知道什么重要,就不要让模型替你决定。
八、什么时候使用 subagents?
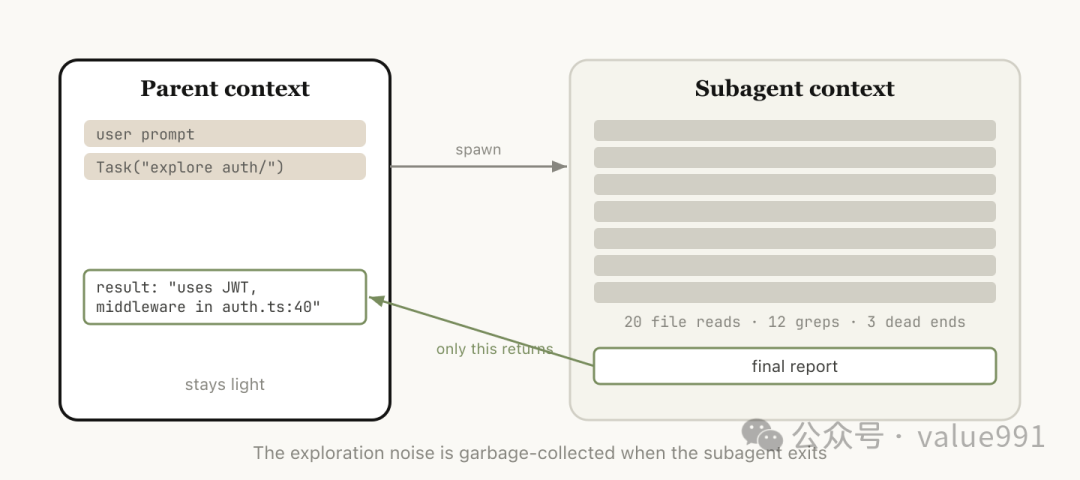
Subagents 适合处理独立任务,尤其是那些会产生大量中间输出,但最终只需要结论的任务。
一个简单判断标准是:
我之后还需要中间过程,还是只需要最终结论?
如果只需要结论,就适合交给 subagent。
例如:
让 subagent 根据 spec 检查当前实现是否符合要求; 让 subagent 阅读另一个代码库,总结它的实现方式; 让 subagent 扫描一批文件,输出问题清单; 让 subagent 根据 git diff 编写功能文档; 让 subagent 做代码审查并给出风险点。
这样做的好处是:
主 session 不会被大量中间输出污染。 子任务完成后,只把结论带回来。 上下文更干净,主任务更稳定。
对复杂项目来说,这是非常重要的能力。
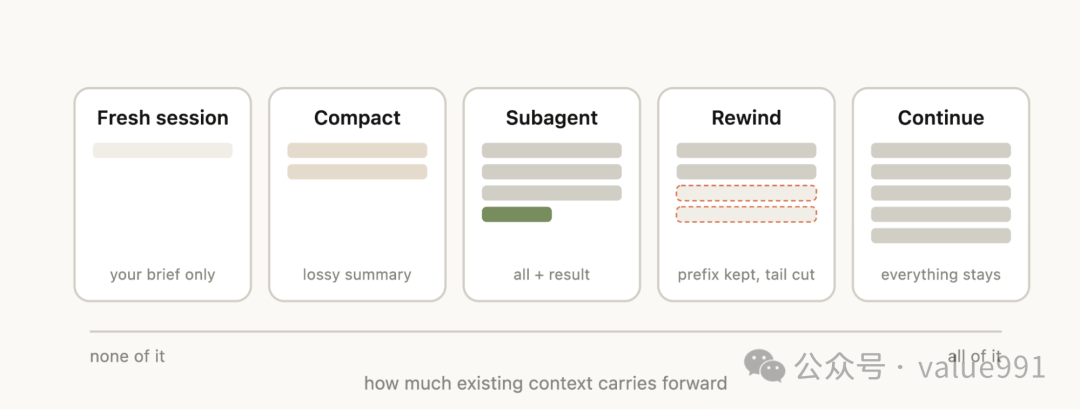
九、一个实用的判断表
可以用下面这套规则快速判断:
继续当前 session 适合任务还在同一条线上,下一步需要依赖刚才的分析和文件读取结果。
开启新 session 适合开始一个新任务、新模块、新页面,或者上下文已经明显不相关。
使用 /rewind 适合 Claude 走错方向,但前面部分上下文仍然有价值。
使用 /compact 适合任务还要继续,但上下文太长,需要保留关键结论、丢掉中间噪音。
使用 /clear 适合当前 session 已经混乱,或者你想自己写 brief,重新建立一个干净上下文。
使用 subagents 适合独立任务、长输出任务、只需要最终结论的任务。
十、给 AI 编程工作流的建议
结合 Claude Code 这篇文章,我认为更好的 AI 编程工作流应该是:
先定义任务边界, 再决定是否新开 session, 把长期规则写进项目文档, 用 /rewind 清理错误路径, 用 /compact 做阶段交接, 用 subagents 隔离复杂子任务, 最后把关键结论沉淀到文件里。
不要把 Claude Code 当成一个永远不断电的聊天窗口。
更好的理解是:
一个 session 就是一段任务工作流。
任务开始,session 开始。 任务结束,session 结束。 重要信息,沉淀到文档。 新任务,用新的上下文重新开始。
Claude Code 的 1M context 很强,但它并不意味着我们可以不管理上下文。
上下文越大,能做的事情越复杂; 但上下文越乱,模型越容易被干扰。
真正高效的使用方式,不是把所有内容都塞进一个 session,而是根据任务状态选择正确的上下文策略。
1M context 不是让你无限堆上下文,而是让你在更大的空间里,更主动地管理上下文。