过去一年,我一直在持续探索 AI Coding Agent 的使用方式。
从最开始使用 ChatGPT 辅助开发,到后来的 Claude Code、OpenAI Codex,再到最近开始测试的 Pi Coding Agent,我一直在尝试寻找一个更加实际的问题答案:
对于开发者来说,如何选择模型和 Agent 组合,才能在代码质量、开发效率以及使用成本之间取得更好的平衡?
刚开始接触 AI Coding Agent 时,我和很多开发者一样,会更加关注模型本身。
哪个模型能力更强?
Claude Opus 是否超过 GPT?
下一代模型是否会完全替代上一代?
但随着实际使用时间增加,我发现事情并没有这么简单。
一个 Coding Agent 的最终表现,并不只是由模型能力决定。模型负责理解问题和生成方案,而 Agent 负责连接模型与真实开发环境,包括代码上下文管理、工具调用方式以及任务执行流程。
因此,一个更强的模型,如果没有合适的 Agent 设计,也不一定能够发挥出最大的价值。
最近 Databricks 发布的一篇文章:
Benchmarking Coding Agents on Databricks’ Multi-Million Line Codebase
让我对这个问题有了更深的认识。
这篇文章比较特别,它没有使用简单的代码生成题目,而是在 Databricks 自己的大规模代码库环境中,对不同 Coding Agent 进行了真实工程任务测试。
测试关注的不只是代码是否完成,同时也关注完成任务需要消耗多少资源,以及不同 Agent 架构对最终结果的影响。
当我看到这篇 Benchmark 时,最大的感受并不是某一个 Agent “击败”了另一个 Agent,而是过去我们评价 AI Coding 工具的方式可能需要重新思考。
未来竞争的核心,可能不只是模型之间的竞争,而是模型、Agent 和工具链组合能力的竞争。
同一个模型,不同 Agent,表现可能完全不同
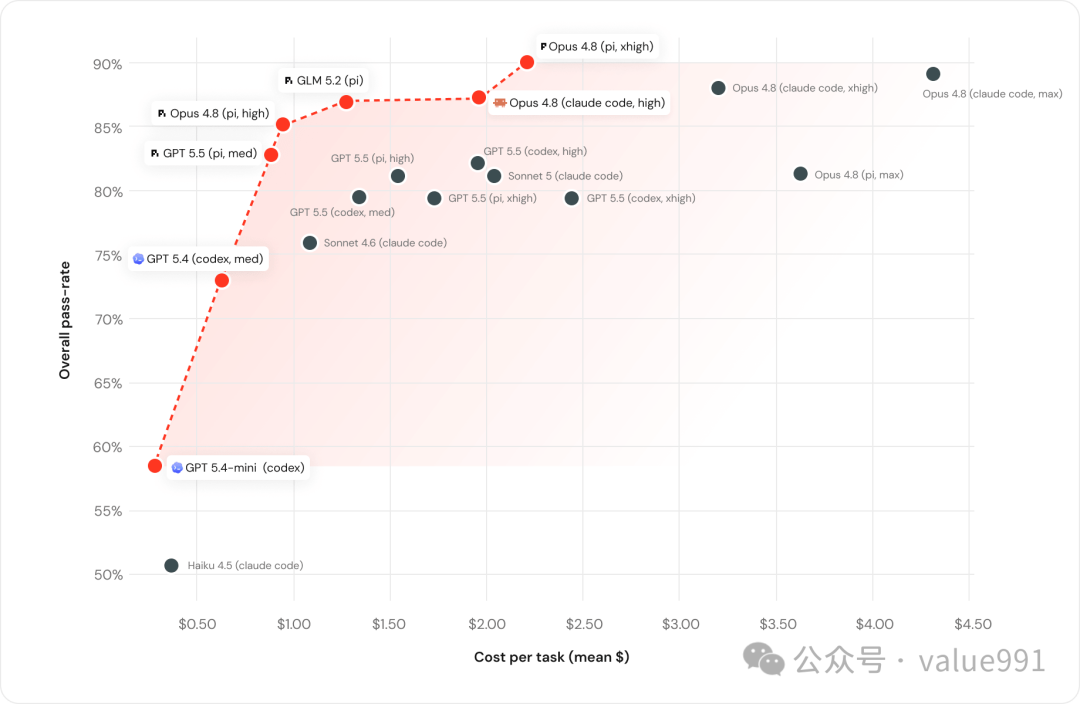
Databricks 的测试中,一个非常值得关注的点是 Claude Opus 4.8 在不同 Agent Framework 下的表现差异。
如果只看模型名称,很多人会自然认为:
Opus 4.8 + Claude Code 应该就是最优组合。
但实际测试结果显示,同样使用 Opus 4.8,不同 Agent 的执行效率和成本存在明显区别。
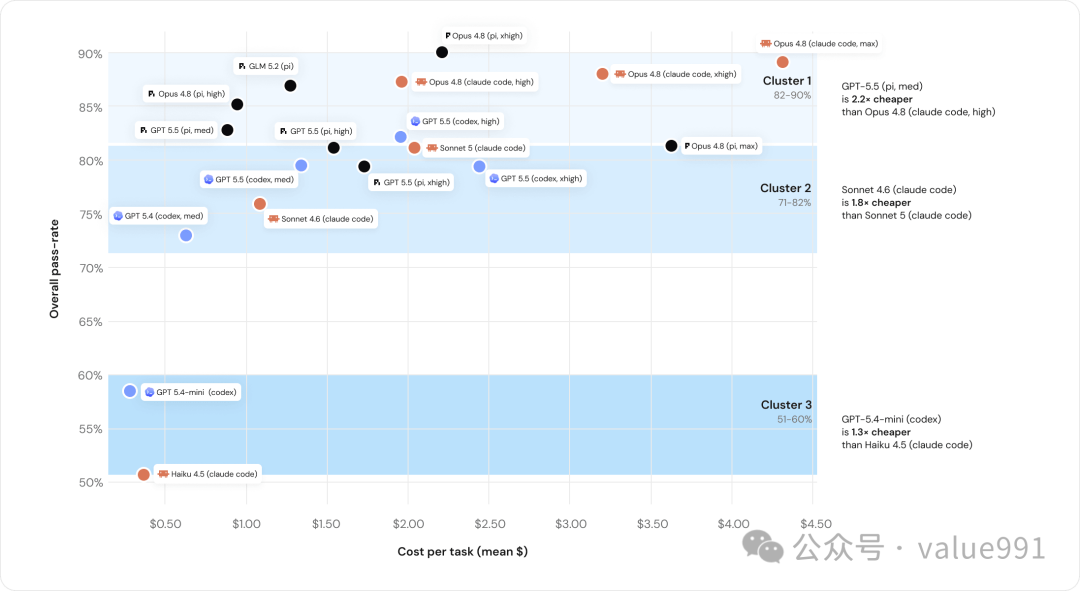
从上面2张图可以看到,模型能力和最终成本之间并不是简单的正相关关系。以 Opus 4.8 为例,Claude Code 和 Pi 在任务完成率上处于相近水平,但成本存在明显差异。
更有意思的是,GPT-5.5 搭配 Pi 的组合也进入了较高的任务完成区间,同时成本明显低于部分 Opus 4.8 方案。
这说明在实际工程场景中,决定效率的不只是模型本身,Agent 对任务执行流程、上下文管理以及工具调用方式的优化,同样会影响最终结果。
Pi 使用更加轻量的 Agent 设计,在保持较高任务完成能力的情况下,降低了上下文消耗和整体成本。
这让我重新思考了 AI Coding Agent 的评价方式。
过去我们更多关注模型本身,例如哪个模型 benchmark 更高、哪个模型参数更多。
但实际开发过程中,真正影响效率的是:
模型是否能够理解复杂代码;
Agent 是否能够提供合适的上下文;
工具调用是否足够高效;
整个执行流程是否减少了无效消耗。
一个模型的能力决定了它能够解决多复杂的问题,而 Agent 的设计决定了这些能力能否有效转化为生产效率。
强模型时代,Agent 需要更加轻量
在早期大模型阶段,Agent 的价值非常明显。
当模型自身推理能力有限时,Agent 可以通过任务拆解、流程控制、知识补充等方式帮助模型完成复杂任务。
但是随着模型能力不断提升,尤其是 Opus 4.8、GPT-5.5 这一代模型出现后,模型已经具备较强的代码理解和自主推理能力。
这时候,Agent 的作用正在发生变化。
它不一定需要替模型规划每一步,而更重要的是提供:
准确的代码环境;
必要的工具能力;
有效的信息输入。
如果 Agent 本身包含大量复杂流程、额外规则以及过多上下文信息,反而可能降低模型的有效工作空间。
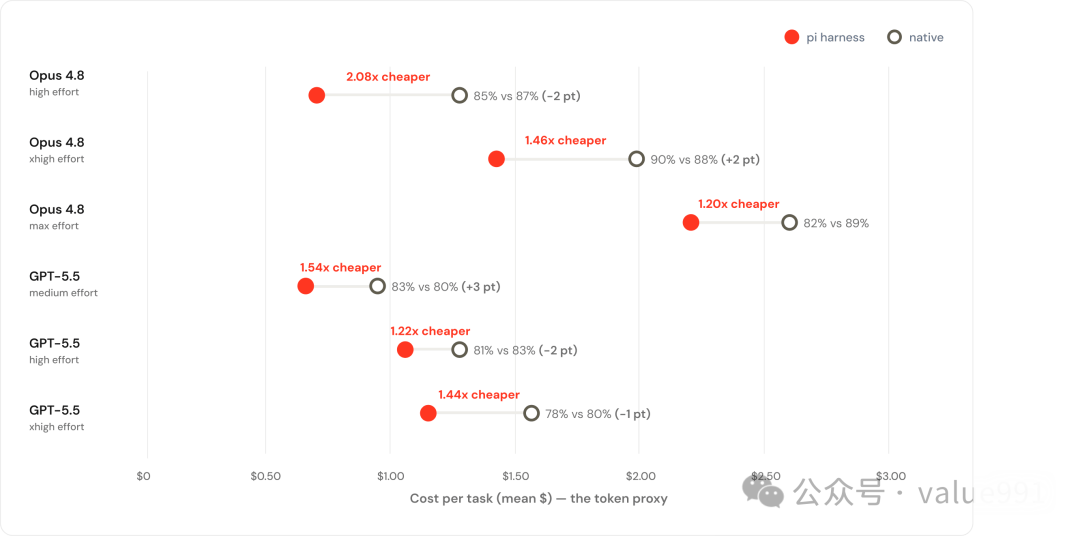
Databricks 的测试结果很好地体现了这一点。通过比较 Pi Harness 和原生 Agent 的表现可以发现,在 Opus 4.8 和 GPT-5.5 等强模型下,Pi 在多个测试配置中能够以更低成本获得接近甚至更好的任务完成效果。
例如 Opus 4.8 high effort 场景下,Pi 的成本降低超过 2 倍,而任务完成率只下降约 2 个百分点;在 Opus 4.8 xhigh effort 场景下,Pi 甚至获得了更高的任务完成率,同时成本降低。
这说明,当模型本身已经足够强时,Agent 的价值不一定来自增加更多流程,而可能来自减少无效消耗,让模型更加高效地工作。
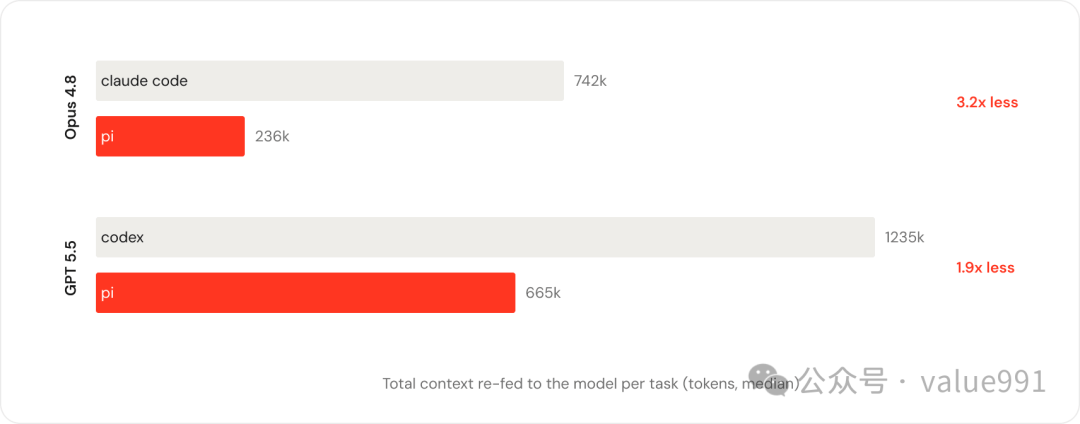
在 Opus 4.8 下:
Claude Code 的上下文消耗约为 742K tokens;
Pi 的上下文消耗约为 236K tokens。
两者存在明显差距。
这种差异并不是来自模型能力,而来自 Agent Framework 对上下文管理方式的不同。
对于已经足够强大的模型来说,减少不必要的干预,让模型拥有更多空间进行自主推理,可能会带来更好的效果。
GPT-5.5、Opus 4.8 以及下一代模型的发展方向
从目前公开的测试结果来看,GPT-5.5 和 Opus 4.8 已经进入非常接近的竞争阶段。
不同模型之间的差距正在缩小,而 Agent 组合带来的影响正在变得更加明显。
这也意味着,未来模型的发展方向可能不会只是单纯提升 benchmark 分数。
下一代模型,例如未来的 GPT-5.6 或 Claude 新版本,更可能重点提升:
复杂代码库理解能力;
长上下文任务稳定性;
工具调用能力;
复杂任务执行可靠性。
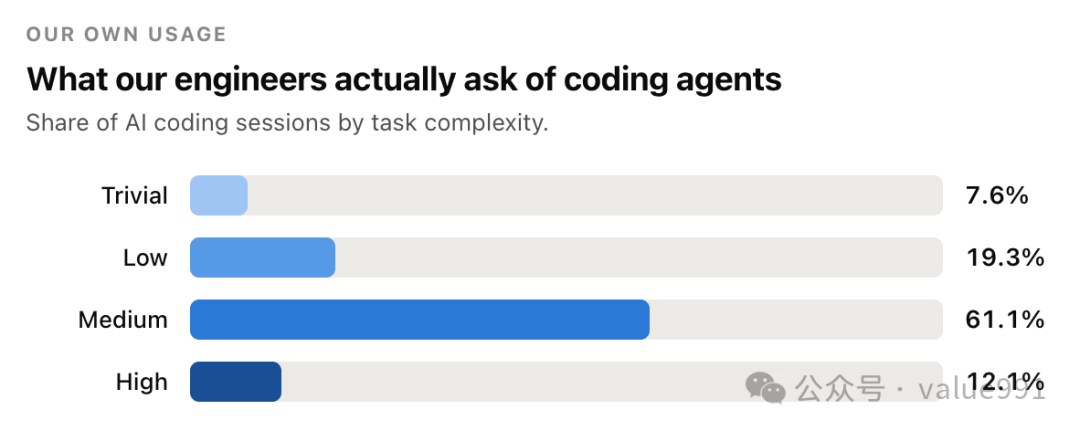
Databricks 同时统计了工程师实际使用 AI Coding Agent 时的任务复杂度分布。数据显示,超过 60% 的 AI Coding 会话属于 Medium 难度任务,而真正高复杂度任务只占约 12%。
这组数据也提醒我们,AI Agent 的价值并不仅仅体现在解决大型重构或者复杂架构问题上。对于日常开发中的代码修改、问题定位、功能调整以及测试补充等中等复杂度任务,Agent 的响应速度、上下文管理能力和成本效率同样重要。
这也是为什么寻找一个合适的模型与 Agent 组合非常重要。并不是每一次任务都需要使用最高成本的模型,也不是所有场景都需要最复杂的 Agent 流程。
模型能力仍然决定上限,但如何让模型稳定完成真实工程任务,会越来越依赖 Agent 设计。
未来可能出现这样的情况:
一个普通 Agent 搭配最新模型,并不一定优于一个优秀 Agent 搭配上一代强模型。
为什么最近开始测试 Pi
目前我日常使用的 AI Coding 工具主要包括:
• Claude Code;
• OpenAI Codex;
• Pi Coding Agent。
每个工具都有自己的优势。
Claude Code 的优势在于完整体验和成熟度;
Codex 的优势在于 OpenAI 生态以及模型能力;
而 Pi 给我的最大感受,是它提供了一种不同的设计思路。
它没有试图构建一个非常复杂的自动化流程,而是尽量保持 Agent 简洁,把更多决策权交给模型本身。
这种方式并不一定适合所有场景,但在强模型时代,它提供了一个非常值得探索的方向。
从 Databricks 的测试结果来看,轻量 Agent 配合强模型,在复杂工程任务中确实具备很大的潜力。
目前 Pi 仍然在持续测试中,我也会继续比较不同模型和 Agent 组合在实际开发中的表现。
本地 AI Agent 未来不会只有一个最佳答案
经过这一年的体验,我越来越认为:
未来不存在一个永远最佳的 AI Coding 工具。
不同模型、不同 Agent Framework,会在不同任务中展现自己的优势。
有些任务更适合快速响应的小模型;
有些复杂工程任务需要 Opus 4.8、GPT-5.5 这样的强模型;
有些场景则需要更加轻量、高效的 Agent 架构。
真正高效的开发方式,不是选择一个所谓“最强工具”,而是找到适合自己工作流的组合。
未来 AI Coding 的竞争,也不会只是模型之间的竞争,而是:
模型能力、Agent 架构以及工具生态的综合竞争。
如果你也在探索本地 AI Agent,我非常推荐尝试不同的模型和 Agent 组合。
Pi 目前还在测试阶段,但它代表了一种非常值得关注的方向。
也欢迎大家分享自己的 AI Coding 工作流,看看在不同场景下,什么样的组合能够带来最高的开发效率。
模型决定能力边界,Agent 决定能力如何转化为效率。
附录:参考资料
1. Pi Coding Agent
官网:https://pi.dev/
Pi 是一个轻量化、可扩展的 Coding Agent Framework。它的设计理念不是构建一个复杂的自动化流程,而是提供一个简洁的 Agent Runtime,让开发者可以根据自己的需求组合模型、工具和工作流。
2. Benchmarking Coding Agents on Databricks’ Multi-Million Line Codebase
原文:https://www.databricks.com/blog/benchmarking-coding-agents-databricks-multi-million-line-codebase
Databricks 通过真实的大规模代码库任务,对不同 Coding Agent 的效果和成本进行了测试。