为什么我用了 Fable 5,感觉工作反而变多了?
最近 Anthropic 的研究员写了一篇关于 Claude Fable 5 的文章。文章里有一个观点很容易让我们忽略:
到了 Fable 5 这一代模型,Agentic Coders 的瓶颈可能已经不再是模型,而是人。
这句话听起来有点反直觉。
我们一直以为,模型越强,工作就应该越少。AI 能写代码、做方案、改文档、画原型、整理需求,理论上应该让人更轻松。
但我最近使用 AI 的真实感受却是:
AI 确实提高了产出效率,但也让我感觉工作反而变多了。
以前一个方案,我可能写一版就觉得差不多了。现在 AI 可以很快生成三版、五版、十版,我反而要花更多时间判断哪一版更对。
以前一个功能,我可能只考虑主流程。现在 AI 会提醒我权限、边界、异常、兼容、历史逻辑、测试用例、交付文档,我反而发现事情并没有我想得那么简单。
以前我以为自己很清楚要做什么。现在 AI 多问我几个问题,我才发现:很多东西我只是“感觉知道”,但并没有真正定义清楚。
所以问题来了:
为什么用了更强的 AI,工作没有变少,反而感觉变多了?
我觉得答案不是 AI 没用,而是 AI 把过去隐藏的工作暴露出来了。
一、其中有一个很有意思的概念:未知项
Anthropic 的文章里讲了一个很重要的概念:Unknowns,也就是“未知项”。
作者用了一个比喻:地图和领土。
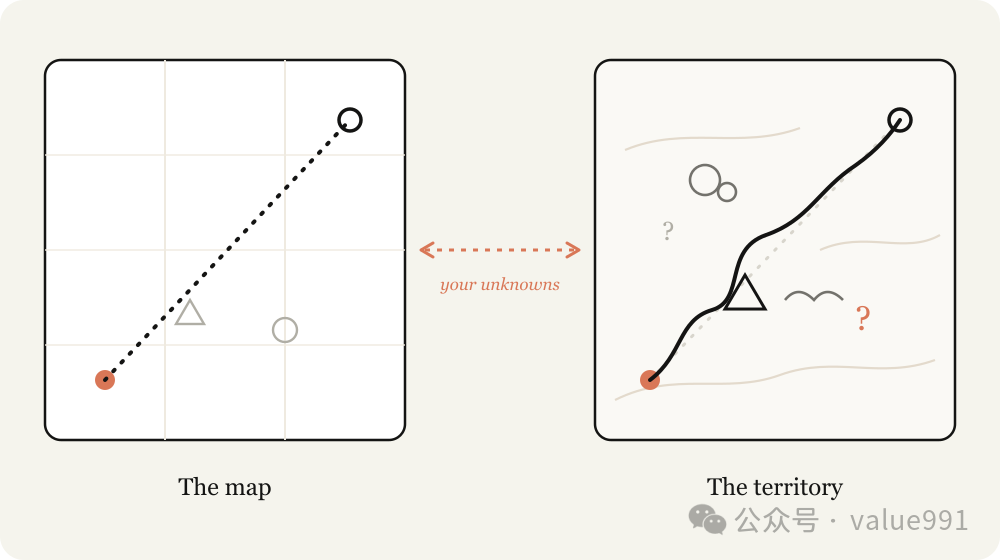
我们给 AI 的提示词、文档、上下文,是“地图”。 真正要解决问题的代码库、业务场景、历史限制、客户需求,是“领土”。
地图永远不可能完全等于领土。
地图和领土之间的差距,就是未知项。
比如你说“做一个登录功能”,你可能以为就是页面加接口。但实际可能涉及认证方式、Token 过期、权限体系、多租户隔离、审计日志、异常处理、老版本兼容、安全策略、测试用例和部署影响。
以前如果没人提醒,你可能会觉得这个工作量不大,甚至会觉得:“这不就是一个登录吗?”
但 AI 会把这些东西列出来。它会问你:这个功能是内部用还是客户用?是临时试点还是长期产品能力?是否要支持多租户?失败后是否重试?是否需要日志?是否会影响历史数据?
这些问题一出来,你会突然发现:
原来不是工作变多了。 而是以前你没有意识到工作本来就这么多。
这也是 AI 最有价值、也最让人不舒服的地方。
它会暴露你的无知。
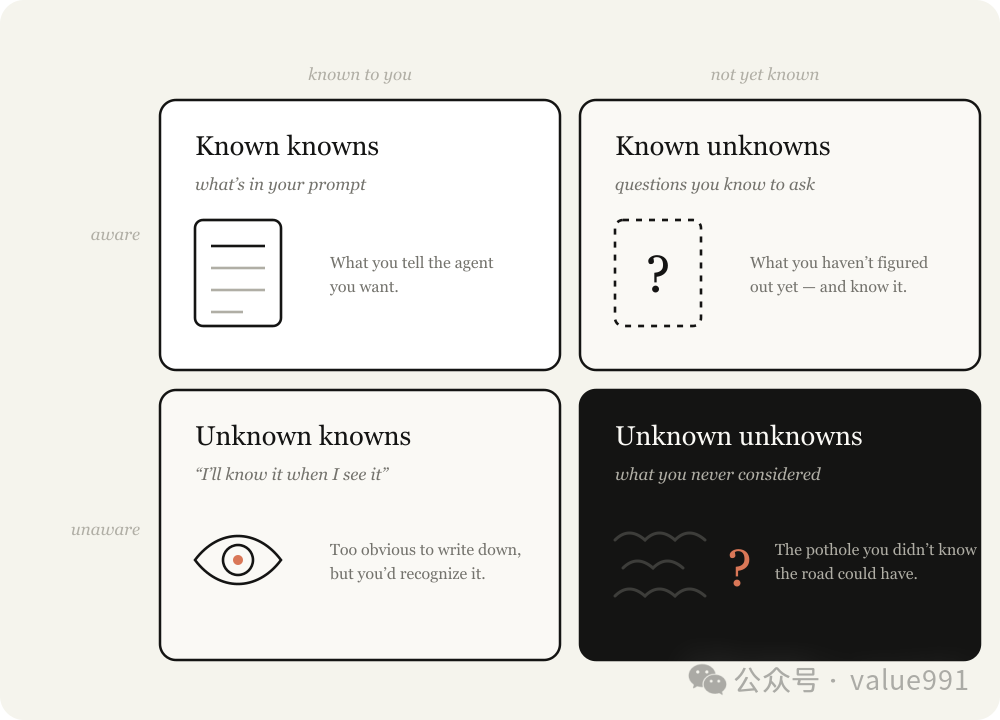
以前觉得一个事情简单,可能不是因为它真的简单,而是因为我们没有能力准确评估它的复杂度。
以前觉得工作量可控,可能不是因为真的可控,而是因为很多未知项没有被纳入评估。
以前觉得需求清楚,可能不是因为真的清楚,而是因为很多默认背景只存在于人的经验里,没有被显性表达出来。
AI 让更多未知变成已知之后,工作自然看起来变多了。
但这不是坏事。
因为一个没有被识别的未知,不会因为你不看见它就消失。它只会在后面以 Bug、返工、延期、客户投诉、需求变更的形式出现。
二、AI 如何帮助我们探索未知?
这篇文章真正有价值的地方,不只是提出了“未知项”这个概念,还给出了一套和 AI 一起探索未知的方法。
它不是让 AI 一上来就执行,而是让 AI 先帮你把问题看清楚。
这个过程可以分成三个阶段:实现前、实现中、实现后。
实现前,重点是找盲点、做原型、让 AI 反问你、提供参考、制定实现计划。 实现中,重点是记录 AI 为什么偏离原计划。 实现后,重点是让 AI 帮你解释结果,甚至反过来测试你是否真正理解了它做的事情。
这套方法看起来会让工作变复杂,但它本质上是在把过去隐性的思考过程显性化。
三、实现前:先做盲点检查
开始工作时,最有用的一件事不是立刻让 AI 干活,而是让 AI 先帮你理解自己的盲点。
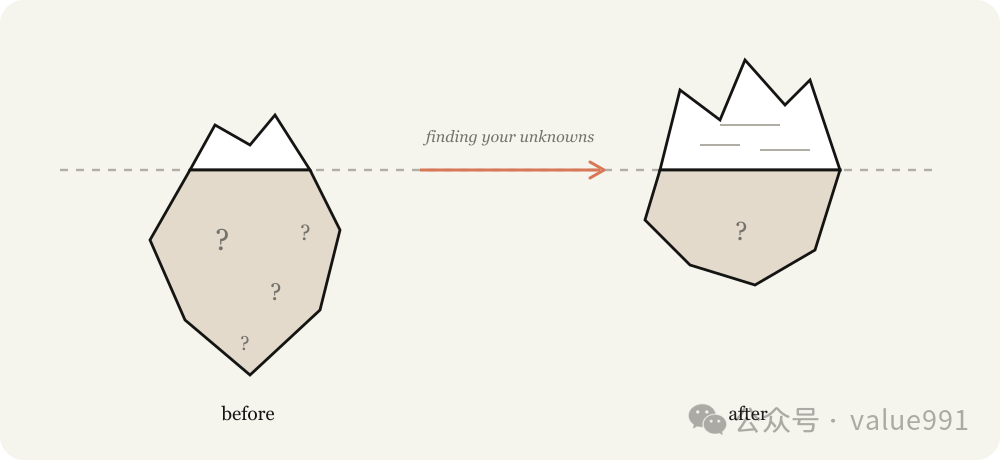
比如你要在代码库中一个陌生模块里写新功能,或者让 Claude 帮你处理你不熟悉的工作,比如设计迭代,那么你很可能会有大量“未知的未知”。
你可能不知道应该问什么问题,不知道什么才算好,不知道历史上做过哪些相关工作,也不知道哪些坑应该避开。
这时可以让 AI 做一次 Blind Spot Pass,也就是盲点检查。
Example prompts:
“I'm working on adding a new auth provider but I know nothing about the auth modules in this codebase. Can you do a blind spot pass to help me figure out my relevant unknown unknowns and help me prompt you better.”
“我正在添加一个新的认证提供商,但我完全不了解这个代码库里的认证模块。你能帮我做一次 blind spot pass,找出我相关的 unknown unknowns,并帮助我更好地给你写提示词吗?”
“I don’t know what color grading is but I need to grade this video. Can you teach me to understand my unknown unknowns about color grading, so that I can prompt better?”
“我不了解 color grading,但我需要给这个视频做调色。你能教我理解关于调色的 unknown unknowns,让我之后能更好地给你提示吗?”
这一步的价值,不是让 AI 立刻给你答案,而是让 AI 先帮你把问题边界照亮。
你可能原本只想做一个简单功能,但 AI 会提醒你:这是不是 Demo?未来是否产品化?是否需要权限控制?是否需要审计记录?是否有多租户隔离?是否会影响历史数据?是否需要兼容旧版本?
这些问题会让你感觉工作突然变多。
但这是好事。
因为你不是在增加工作,而是在减少未来的返工。
四、实现前:用头脑风暴和原型逼出真实判断
还有一种情况更常见:
你不是完全不知道,而是说不清楚。
比如一个页面要怎么设计,一个方案要怎么表达,一个功能要做到什么程度,一个产品 Demo 要呈现成什么风格。
你脑子里隐约有感觉,但很难一次性写成清晰需求。
这时候,不要强迫自己一开始就写出完美提示词。可以让 AI 先做几个方向。
Example prompts:
"I want a dashboard for this data but I have no visual taste and don't know what's possible. Make me an HTML page with 4 wildly different design directions so I can react to them.”
“我想给这些数据做一个 dashboard,但我没有视觉品味,也不知道可以做成什么样。请做一个 HTML 页面,给我 4 个完全不同的设计方向,我想先看看再反应。”
“Before wiring anything up, make a single HTML file mocking the new editor toolbar with fake data. I want to react to the layout before you touch the real app."
“在接任何真实逻辑之前,请先做一个单独的 HTML 文件,用假数据模拟新的编辑器工具栏。我想先确认布局,再让你改真实应用。”
"Here's my rough problem: users churn after onboarding. Search the codebase and brainstorm 10 places we could intervene, from cheapest to most ambitious. I'll tell you which ones resonate."
“这是我的粗略问题:用户在 onboarding 后流失。请搜索代码库,并头脑风暴 10 个我们可以介入的地方,从成本最低到最激进都列出来。我会告诉你哪些方向有感觉。”
这一步很重要。
因为很多判断不是在写需求时出现的,而是在看到结果时出现的。
你看到第一个版本,会觉得太轻。看到第二个版本,会觉得太像模板。看到第三个版本,会觉得适合客户。看到第四个版本,可能会发现原来自己真正想要的是另一种结构。
这不是浪费时间。
这是探索。
AI 的价值不是一次性命中你的想法,而是用很低的成本帮你把模糊想法外化,让你有东西可以判断、比较、修正。
五、实现前:让 AI 反过来采访你
当头脑风暴和原型之后,通常仍然会有很多不确定的地方。
这时,最好的方式不是继续自己硬写提示词,而是让 AI 反过来问你问题。
Example prompt:
"Interview me one question at a time about anything ambiguous, prioritize questions where my answer would change the architecture."
“请围绕任何模糊点一次问我一个问题。优先问那些我的答案会改变架构设计的问题。”
这个提示词的关键在后半句。
我们不是让 AI 随便问问题,而是让它优先问那些会改变结果的问题。
如果一个问题的答案会影响架构、范围、权限、交付、成本和时间,那这个问题就应该提前问。否则它晚一点出现,就可能变成返工。
这也是 AI 让工作变多的地方。
以前很多问题不会在一开始被问出来。现在 AI 会逼你提前面对它们。
这确实会让人不轻松,但它也会让项目更真实。
六、实现前:参考资料比抽象描述更有用
有时你不是不想说清楚,而是真的很难说清楚。
比如你喜欢某个产品的交互方式,喜欢某个组件的代码结构,或者想要复刻某个库里的行为逻辑。你可以描述半天,但效果可能不如直接给参考资料。
文章里提到,最好的参考往往不是截图,而是源代码。因为源码能提供比图片更丰富的结构、语义和实现细节。
Example prompt:
"This Rust crate in vendor/rate-limiter implements the exact backoff behavior I want. Read it and reimplement the same semantics in our TypeScript API client."
“vendor/rate-limiter 里的这个 Rust crate 实现了我想要的精确 backoff 行为。请阅读它,并在我们的 TypeScript API client 里重新实现同样的语义。”
这背后的启发是:
当你说不清楚时,不要只靠形容词。
不要只说“高级一点”“专业一点”“像某某产品一样”“逻辑更严谨一点”。
更好的方式是提供参考,让 AI 去对齐真实样本。
这会减少误解,也会减少 AI 的自由发挥。
七、实现前:先写实现计划,而不是直接动手
当你觉得差不多可以开始实现时,也不要急着让 AI 直接改代码。
更稳妥的方式,是让它先写一份实现计划。
但这份计划不应该只是流水账,而应该把最容易变化、最需要你判断的部分放在前面。
Example prompt:
"Write an implementation plan in HTML, but lead with the decisions I'm most likely to tweak with: data model changes, new type interfaces, and anything user-facing. Bury the mechanical refactoring at the bottom, I trust you on that part."
“请用 HTML 写一份实现计划,但先把我最可能修改的决策放在前面:数据模型变化、新的类型接口、任何用户可见的内容。机械性的重构放在最后即可,那部分我信任你。”
这个方法很实用。
因为真正需要人 Review 的,往往不是那些机械执行部分,而是方向性决策。
数据模型一旦错了,后面会很麻烦。用户流程一旦错了,功能做完也不好用。类型接口一旦错了,后续扩展会变得别扭。
所以实现计划不是为了拖慢进度,而是为了把关键决策提前暴露出来。
它会让你更早意识到:这个需求到底有没有想清楚。
八、实现中:让 AI 记录每一次偏离
就算实现前想得再清楚,真正进入执行时仍然会遇到新问题。
代码库里有历史逻辑,客户环境有特殊限制,旧版本有兼容要求,某个接口可能不是文档里写的那样,某个功能和另一个模块可能存在隐藏依赖。
这时 AI 可能会偏离原计划。
如果不记录,你最后只会看到一个结果,却不知道过程中发生了什么。
所以在实现中,可以要求 AI 维护一个 implementation-notes.md。
Example prompt:
"Keep an implementation-notes.md file. If you hit an edge case that forces you to deviate from the plan, pick the conservative option, log it under 'Deviations', and keep going."
“请维护一个 implementation-notes.md 文件。如果你遇到迫使你偏离原计划的边缘情况,请选择保守方案,把它记录在 ‘Deviations’ 下面,然后继续推进。”
这一步会继续增加你的 Review 工作。
因为你不仅要看代码,还要看 AI 的决策记录。
但这很重要。
AI 时代最危险的事情,不是 AI 写错代码,而是 AI 写了很多代码,你却不知道它为什么这么写。
实现笔记可以把 AI 的工作过程从黑箱变成半透明。你可以知道它哪里按计划做了,哪里偏离了,哪里做了保守选择,哪里留下了后续风险。
这不是额外负担,而是必要的工程治理。
九、实现后:不要只交付结果,还要准备解释材料
很多工作做完之后,并不是代码合并或文档完成就结束了。
你还要让别人理解它、相信它、批准它。
这就是为什么实现后需要提案与解释材料。
你可以让 AI 把原型、规格文档、实现笔记整理成一份可以发给团队或客户的说明材料。重点不是炫技,而是降低别人的理解成本。
Example prompt:
"Package the prototype, the spec, and the implementation notes into a single doc I can drop in Slack to get buy-in. Lead with the demo GIF."
“请把原型、规格文档和实现笔记打包成一份文档,我可以直接发到 Slack 里争取认同。开头先放 demo GIF。”
这类材料很容易被低估。
但现实工作里,很多事情不是做不出来,而是别人不知道你为什么这么做,也不知道你考虑过哪些风险。
当 AI 帮你把这些解释清楚,项目推进会更顺。
这也是 AI 把隐藏工作显性化的一个表现。
以前很多解释靠会议讲,靠口头同步,靠负责人自己补充。现在 AI 可以帮助你把它变成结构化材料。
十、实现后:不要只验收结果,还要让 AI 考你
当 AI 完成一项复杂任务后,很多人会直接看结果。
页面能不能跑?代码有没有报错?文档看起来顺不顺?方案是不是完整?
但这还不够。
因为 AI 可能完成了很多你没有意识到的事情。它可能改了多个文件,引入了新的逻辑,处理了边缘情况,修改了历史流程,也可能做了一些假设。
如果你只是浅浅看一遍,很容易出现一个问题:
东西是 AI 做的,但责任还是你的。
所以更好的方法是,让 AI 在实现后给你做一份解释报告,并且出一套测验。
Example prompt:
“I want to make sure I understand everything that's happened in this change. Give me a HTML report on the changes for me to read and understand with context, intuition, what was done, etc. and a quiz at the bottom on the changes that I must pass.”
“我想确认自己完全理解这次变更发生了什么。请给我一份 HTML 报告,解释这些变更,包括上下文、直觉、完成了什么等等,并在底部附一个我必须通过的测验。”
这听起来有点麻烦,但非常必要。
因为 Review 不只是挑错。 Review 也是理解。
如果你无法通过 AI 给你的测验,说明你其实还没有真正掌握这次变更。如果你没有掌握,就不应该轻易合并、上线或对外承诺。
AI 越强,我们越需要建立理解机制。否则产出速度越快,失控风险也越高。
十一、所以,为什么用了 AI 之后工作反而变多了?
回到最开始的问题:
为什么我用了 Fable 5,感觉工作反而变多了?
我觉得主要有两个原因。
第一个原因,是需要 Review 的东西变多了。
以前人的产出速度有限,你可能只需要看一版方案、一个页面、一个实现方向。现在 AI 可以快速生成多个版本,你就必须判断哪个方向更对,哪些建议能落地,哪些内容只是看起来完整。
AI 把执行速度提高了,但也把选择和判断的压力交还给了人。
第二个原因,是更多未知在 AI 的帮助下变成了已知。
以前我们觉得工作简单,很多时候不是因为事情真的简单,而是因为我们看不见复杂度。我们没有意识到边界、异常、历史逻辑、权限、交付、验收和维护成本,也就无法准确评估工作量和所有未知。
AI 会把这些问题提前摆出来。
它让我们意识到:很多过去所谓的“效率”,其实是靠省略思考换来的。
所以,工作到底是变多了,还是变真实了?
表面看,是变多了。你要写更多上下文,要 Review 更多版本,要回答 AI 更多问题,要判断更多方向,要看实现笔记,要理解 AI 的改动,还要做更多验收和验证。
但从另一个角度看,也许不是工作变多了。
而是工作变真实了。
以前被忽略的未知,现在被看见了。以前被跳过的探索,现在被补上了。以前靠经验传递的判断,现在被写下来了。以前后期才爆出来的问题,现在提前暴露了。
这当然会让人感觉累。
因为看见复杂度,本身就是一种负担。
但对真正想把事情做好的人来说,这也是一种机会。
你越早看见未知,越有机会控制风险。你越早探索方向,越有机会做出创新。你越早定义问题,越有机会避免返工。你越早理解复杂度,越有机会准确评估工作量。
AI 不是简单地让工作减少。AI 更像是把工作的水位降低,让原本藏在水下的石头露出来。
你可以抱怨石头太多。 也可以庆幸自己终于看见了它们。
十二、探索未知,也是创新和思考的过程
最后我想说一个更矛盾的问题。
当 AI 帮我们发现未知,帮我们整理思路,帮我们提出问题,帮我们生成方案,帮我们做原型时,它到底是在完善我们的工作,还是在磨灭我们的创新?
这个问题没有简单答案。
一方面,AI 确实能让工作更完整。它能提醒我们遗漏的风险,扩展我们的思路,把模糊想法变成可讨论的产物,也能帮助我们更快看到多个方向。
但另一方面,如果我们只是被动接受 AI 的答案,不再自己思考,不再自己判断,不再经历探索的痛苦,那么创新也可能被削弱。
因为探索未知,本身就是创新的一部分。
你不知道,所以你去问。 你不确定,所以你去试。 你看不清,所以你做原型。 你不满意,所以你推翻重来。
你在模糊中寻找边界,在混乱中建立秩序。
这个过程很慢,也很累。但很多真正有价值的想法,正是在这个过程中出现的。
所以我越来越觉得,AI 最好的用法不是替代思考,而是放大思考。
让 AI 帮你发现未知,但不要让它替你决定价值。 让 AI 帮你生成方向,但不要让它替你判断取舍。 让 AI 帮你完善工作,但不要让它磨平你的直觉和创造力。
Fable 5 这样的模型越强,我们越需要重新理解人的角色。
人不应该只是一个提示词输入器。
人应该是问题的定义者、方向的判断者、价值的选择者,以及创新过程的负责人。
所以,为什么我用了 Fable 5,感觉工作反而变多了?
因为它让我看见了更多未知。
而看见未知,正是认真工作的开始。
至于这些未知最后会完善我们的工作,还是磨灭我们的创新,取决于我们怎么使用 AI。
AI 可以让人变懒。 也可以让人变深。
当然,我严重怀疑。Anthropic 有推销token的嫌疑,但是这依然值得我们参考和借鉴。
有关键不在模型。 关键仍然在人。
Anthropic 博客地址A field guide to Claude Fable 5: Finding your unknowns:https://claude.com/blog/a-field-guide-to-claude-fable-finding-your-unknowns