人的很多判断,其实快得惊人。
过马路时看到一辆车突然靠近,我们会立刻往后退;看到一只猫,几乎一瞬间就知道“这是猫”;开车时前车突然刹车,很多时候我们甚至还没来得及认真思考,脚已经踩下去了。
这些判断并不是经过一长串推理才得出结果,而更像是大脑已经形成的一种快速反应。
但今天的大模型恰恰相反。
哪怕最终只是回答一个“是不是”“选哪个”,模型通常也要先理解上下文,再进行推理,然后一个 Token 一个 Token 地生成答案。
而最近出现的一个模型,正是试图把这种“快速判断”单独做成一种 AI 能力。这个号称在特定工作流中比传统大模型快 193.6 倍的模型,就是 Jev。
TypeSafe 将它称为:
The first public System One Model.
也就是第一个公开发布的 System One Model。
那什么是 System One?
System One 这个名字来自 Daniel Kahneman 的《思考,快与慢》。
书里把人的思考大致分成两种。
一种是 System 2。
缓慢、需要集中注意力,需要一步一步推理。比如计算一道复杂数学题、制定一个商业计划,或者解决一个从来没有遇到过的问题。
另一种是 System 1。
快速、直觉、自动发生。看到猫知道是猫,遇到危险立即躲避,听到熟悉的问题,答案几乎直接从脑子里跳出来。
TypeSafe 借用了这个概念。当然,Jev 并不是在模拟人脑,也不是某种生物神经网络。他们真正提出的问题其实很简单:
现实世界里有大量任务,最终只是需要做一个判断。为什么每一次都要调用一个擅长长篇生成和复杂推理的大模型?
比如:
这笔交易是否异常?这个用户是不是准备流失?这个请求应该分给哪个部门?这个 Agent 是否已经完成任务?这个结果需不需要人工复核?
这些问题可能需要理解非常复杂的上下文,但最终需要的不是一篇文章。而是一个 Decision。
所以 TypeSafe 对 Jev 的定义是:
Unstructured state in, typed probabilistic decisions out.
输入可以是一段文本、一组数据,甚至整个软件当前的运行状态。Jev 输出的是提前定义好的决策类型,以及相应的概率和置信度。
比如:
欺诈概率: 3% 风险: 低 人工复查: 否
这也是 TypeSafe 官网另一句话的含义:
Jev gives AI the properties of code.
他们希望 AI 不再只是给人生成语言,而是能够像代码一样被软件直接调用。官网把这种形态称为 Machine-Native Intelligence。
它为什么能快这么多?
TypeSafe 官网最醒目的数字就是:
193.6x Faster 、444.6x Cheaper
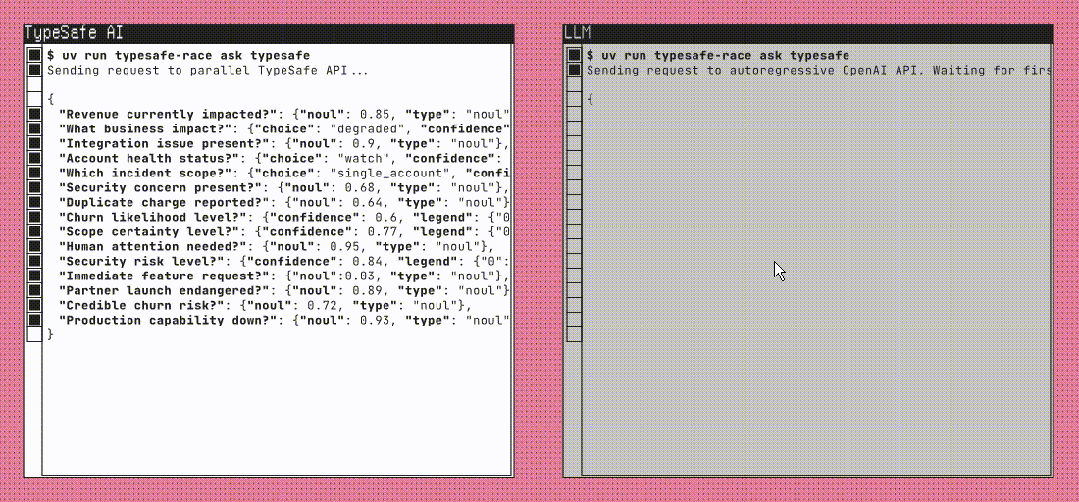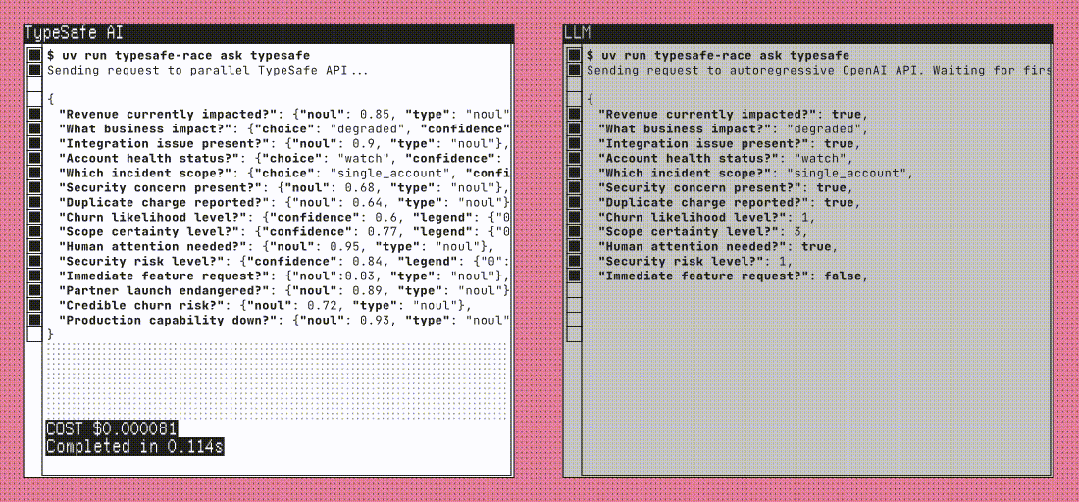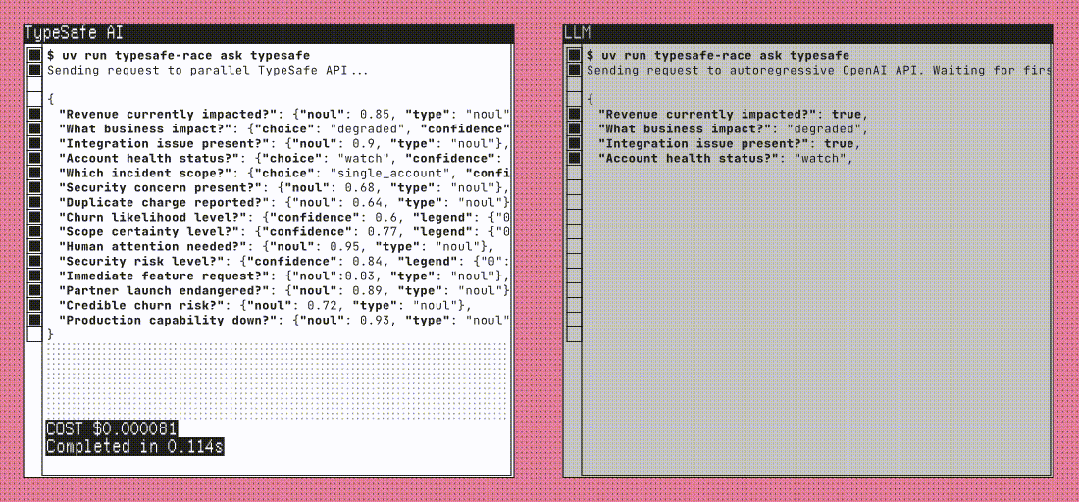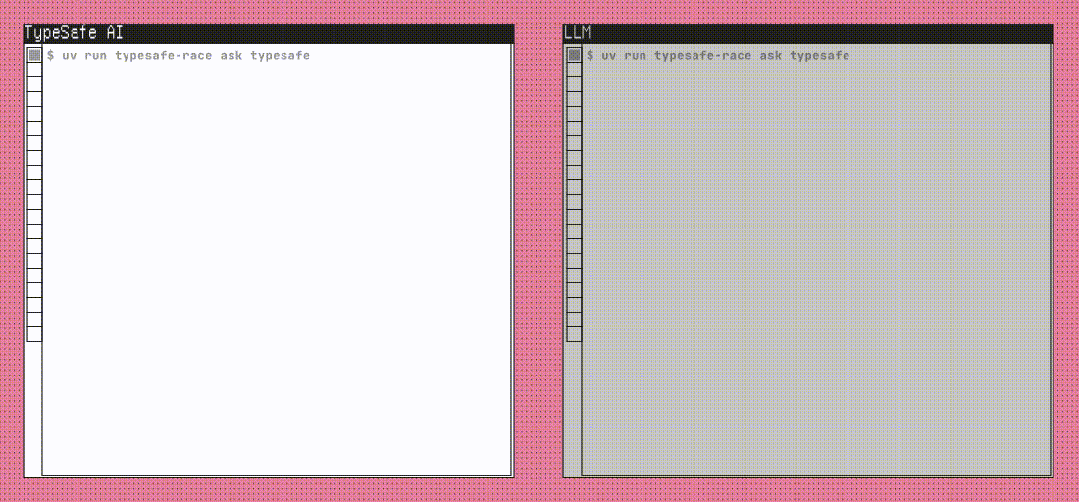
除此之外,Jev 官方公布的端到端响应时间大约在 70ms~500ms。
价格同样非常低。目前官方公布的是:
每 10 亿输入 Token 42 美元。
也就是每百万输入 Token 约 0.042 美元。输出则没有单独计费。所以官网干脆写了一句话:
Jev’s intelligence per dollar is literally off the charts.
为什么可以做到这样?
最核心的区别之一,就是 Jev 不再以生成字符串为主要输出方式。
传统 Chat Model 本质上是一个自回归生成模型。大致过程是:
输入 → 理解 / 推理 → Token 1 → Token 2 → Token 3 → Token 4 ……
后一个 Token 依赖前一个 Token。
模型输出得越多,需要进行的生成过程也越多。
哪怕最终软件真正需要的只是:YES / NO
传统大模型仍然是从一个“可以写文章、写代码、聊天、推理”的通用生成模型中得到这个结果。Structured Output、JSON Schema、Function Calling 已经可以很好地约束这种输出,但底层仍然是一个以 Token Generation 为核心的模型。
Jev 选择的是另外一条路。
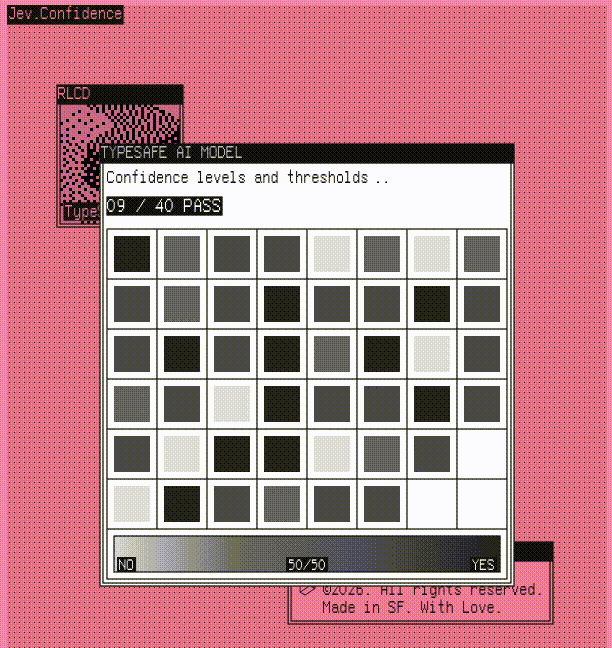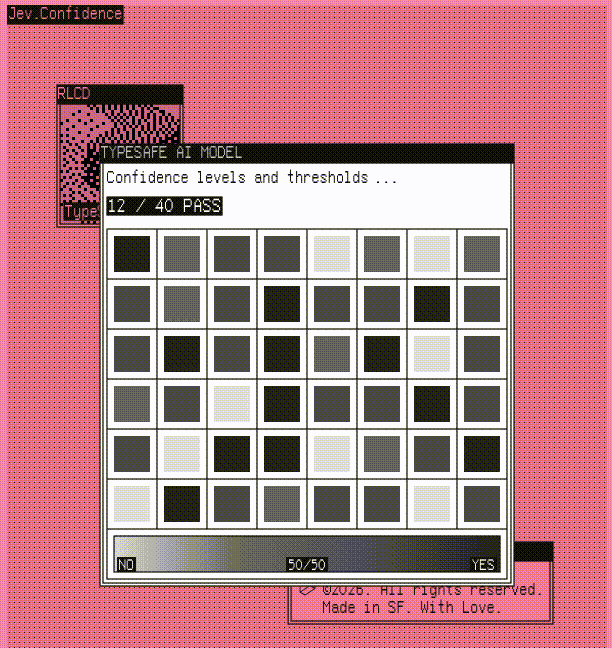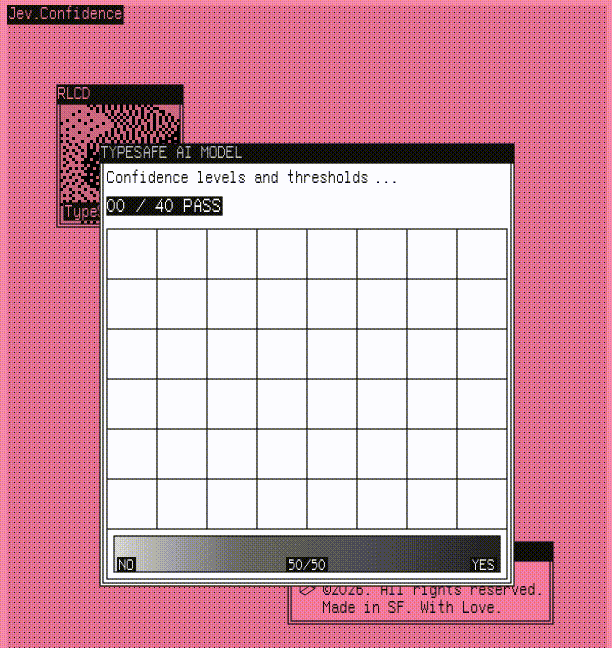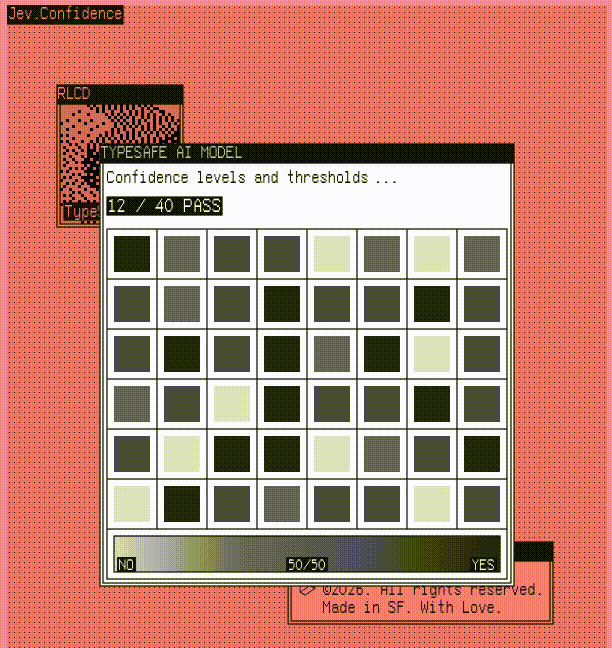
TypeSafe 表示,他们为 System One Model 重新设计了模型架构、Sampler 和训练方法,并使用 Parallel Sampling,让多个决策可以在一次 Query 中并行产生,而不是逐 Token 生成一段字符串。
换句话说,它放弃了一部分生成模型的自由度,换来了:
更快的速度、更低的成本,以及更适合软件直接消费的输出。
TypeSafe 官网有一句话很好地总结了他们的思路:
We took the opposite research direction.
过去几年,整个 AI 行业一直在研究怎么让模型:
想得更多,推理得更久,生成得更好。TypeSafe 反过来问:
哪些事情其实根本不需要想那么多?
我觉得 Jev 另一个值得关注的点,其实不是速度,而是 Calibration。TypeSafe 为此设计了一套新的训练方法:
RLCD——Reinforcement Learning for Calibrated Decisions。
我们过去比较熟悉的是 RLHF。它主要解决:
什么样的回答更符合人的偏好?
而 RLCD 想解决的是另外一个问题:
模型对自己的判断到底有多确定?
例如 Jev 判断:
欺诈: 90%
理想情况下,经过大量统计,那些被模型判断为 90% 的事情,最终真的应该大约有 90% 被证明是正确的。这对于自动化其实非常重要。因为现实世界并不要求 AI 永远不犯错。
真正重要的是:
AI 能不能知道自己什么时候可能错。
这样软件就可以设置自己的规则。
例如:
Confidence > 99% 自动执行 80%~99% 交给更强模型复核 < 80% 交给人工
AI 的不确定性,不再只是模型自己的一句“我不太确定”。而是可以真正成为软件逻辑的一部分。这也是 Jev 和代码结合起来以后比较有意思的地方。当然,TypeSafe 官网还用了 Zero Hallucinations 这样的说法。
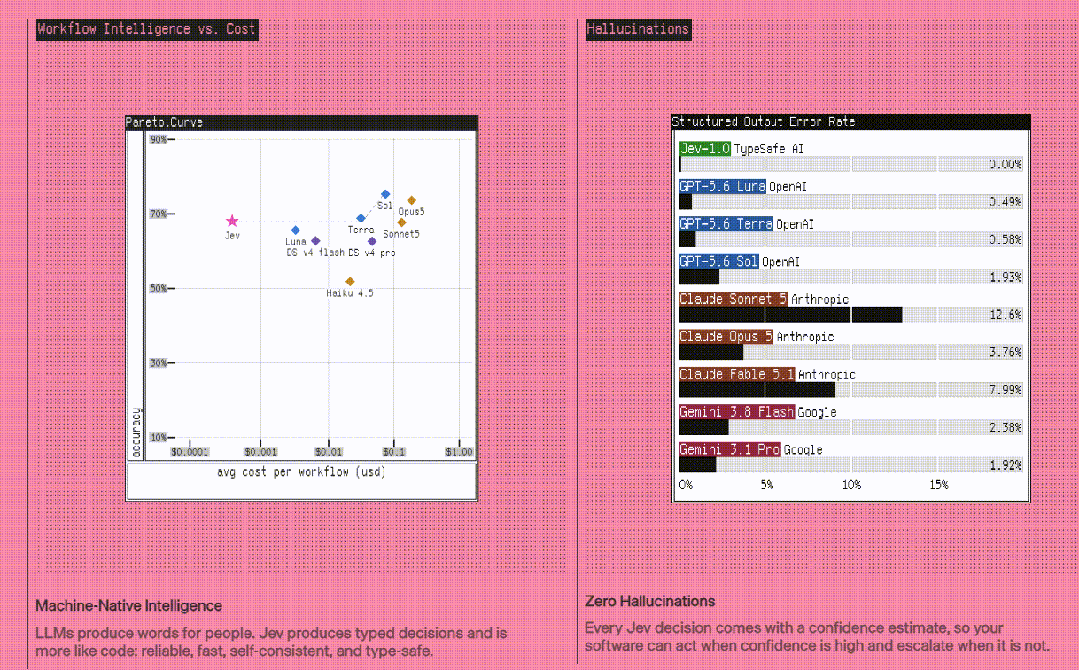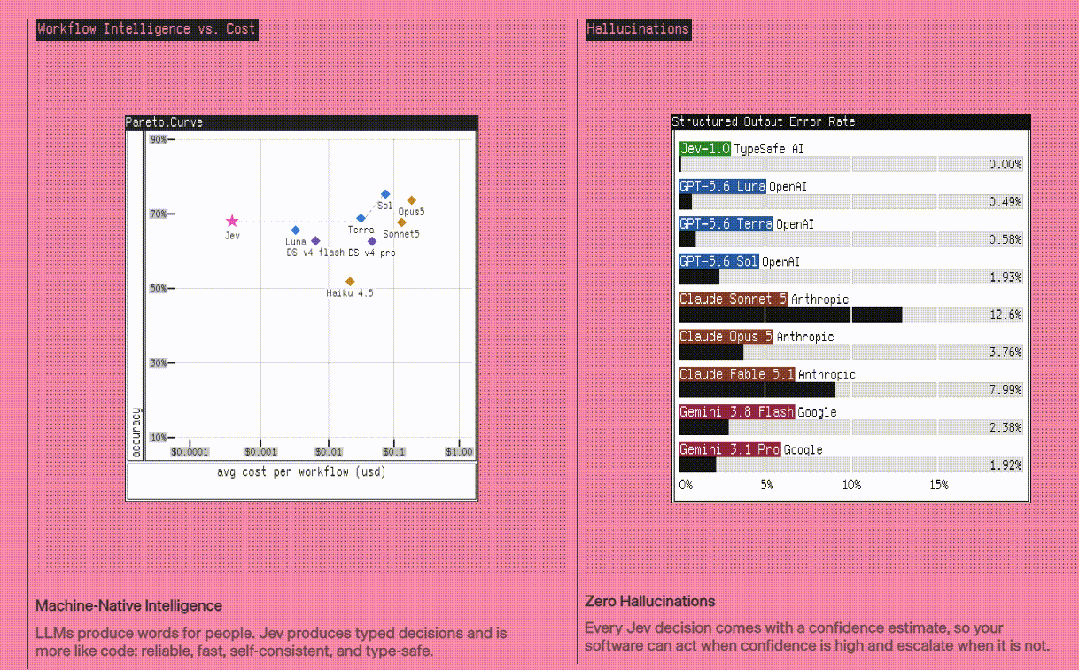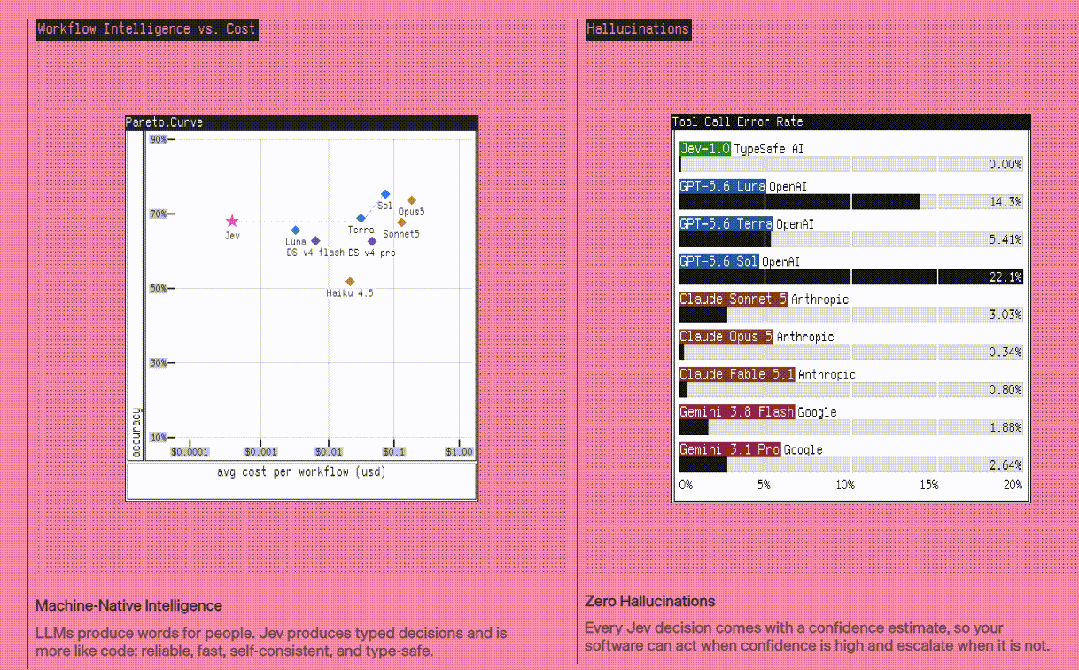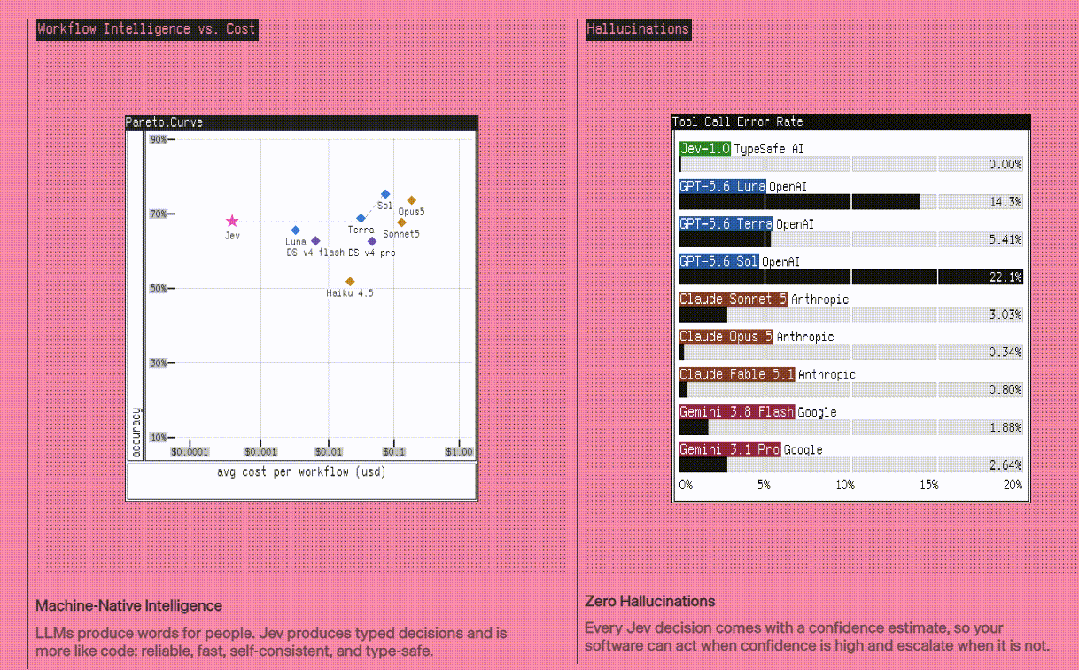
这里不能简单理解成“Jev 永远不会判断错误”。
更准确地说,TypeSafe 所强调的是 Jev 的 Type Safety 和 Schema Matching:由于可能的输出类型提前定义,它不会产生 Schema 之外的输出或类型错误。
但:
不会输出错误的类型,不等于不会做出错误的判断。
Jev 当然仍然可能判断错。这也是 Calibration 为什么重要。
这么简单的想法,为什么现在才出现?
这是我看到 Jev 后觉得最有意思的问题。因为判断、分类、评分、预测,根本不是什么新的 AI 能力。垃圾邮件过滤是在判断。推荐系统是在判断。金融风控是在判断。
现在大模型里的 Reward Model、Router、Moderation Model,本质上也都在做判断。这些东西很早就存在。
真正的问题是:
过去的 Decision Model 太专用了。
一个垃圾邮件模型主要解决垃圾邮件。一个欺诈模型解决欺诈。一个推荐模型解决推荐。每增加一种新的判断任务,都可能意味着重新准备数据、重新训练和部署一个模型。
而 LLM 过去几年真正证明的一件事情是:
自然语言本身可以成为定义任务的接口。
同一个模型能够理解完全不同的问题。所以我的理解是,Jev 真正出现的条件,不是到了今天人们才突然意识到:
“AI 原来可以做决策。”
而是直到今天,我们才开始有机会把两件事情放到一起:
大模型的通用理解能力 和 传统 Decision Model 的高效率与确定性。
保留通用理解。但是不一定要保留自由文本生成。这可能才是 Jev 真正值得关注的地方。
我不认为 Jev 是来替代 GPT 的。
如果这条路线成立,它们很可能反而会长期共存。真正困难、开放式的问题,继续交给 GPT、Claude、Gemini 这样的 Reasoning Model。而大量能够被结构化成决策的问题,则交给 Jev 这一类 Decision Model。
最后再由代码真正执行。
整个系统可能逐渐变成:
Reasoning Model 负责思考↓Decision Model 负责判断、路由、评分、验证↓Code 负责执行
这其实会改变我们现在对 AI 的一个惯性认识。
过去几年大家一直在追求:
一个越来越强的通用模型。
写作是它。Coding 是它。数学是它。Tool Calling 是它。路由是它。验证答案还是它。
几乎所有智能任务,都试图交给同一个模型完成。但真正成熟的计算机系统从来不是这样的。
今天一台计算机里有 CPU、GPU、内存、数据库、缓存、网络以及各种专用处理器。不同类型的计算,由不同系统负责。AI 最终也可能走向类似的结构。
未来真正成熟的 Intelligence Stack 可能包括:
Reasoning、Decision、Memory、World Model、Verifier、Execution
不同的模型,负责不同类型的“智能”。所以 Jev 真正让我感兴趣的问题其实并不是:
它到底是不是真的比 GPT 快 193 倍?
而是:
为什么我们一直默认,所有智能都应该由同一种模型完成?
现实世界里真正数量巨大的智能需求,很可能根本不是聊天,也不是写文章。
而是:
要不要?是不是?选哪个?多少分?下一步去哪?是否异常?是否可信?
这些判断存在于支付、广告、推荐、金融、安全、客服、游戏、工业系统,以及未来几乎所有 Agent 中。
它们的数量,理论上可以远远超过人与 AI 的对话次数。
这也解释了为什么这个模型叫 Jev。
Jev 来自经济学家 William Stanley Jevons,以及著名的 Jevons Paradox——杰文斯悖论。
一种资源的使用效率提高以后,总消耗量不一定下降。相反,因为成本下降,会出现大量以前根本不会使用它的新场景。
TypeSafe 认为,Intelligence 也可能遵循同样的规律:
每当机器智能的成本下降一个数量级,就会解锁更多原本不值得使用 AI 的场景。
今天,我们可能一天主动问 ChatGPT 几十个问题。未来,一个软件内部却可能每天自动发生几百万次 AI Decision。到那个时候,AI 可能不再只是一个我们主动打开的产品。而会越来越像数据库、搜索、缓存一样,成为软件内部的一种基础能力。
今天代码里到处都是:
if (...)
未来也许会出现越来越多类似:
AI_DECIDE(...)
过去几年,我们一直在研究怎么让 AI 想得更多。
Jev 提出的另外一个问题是:
哪些事情,其实根本不需要想那么多?
目前 Jev 还处于 Early Access 阶段,最漂亮的数据也基本来自 TypeSafe 自己。所以现在还不需要急着给它下结论。
真正值得看的,是放到真实任务之后:
准确率怎么样?Calibration 是否真的可靠?复杂输入下还能不能保持这样的速度?
所谓的 System One Model,究竟只是一个包装得很好的新概念,还是今天的 AI 系统里真的缺失了这样一层。
等测试。
特别说明与引用
本文关于 Jev 的模型定义、System One Model、RLCD、Parallel Sampling、70ms~500ms 响应时间、每 10 亿输入 Token 42 美元,以及 “193.6x Faster、444.6x Cheaper” 等数据,均来自 TypeSafe AI 官方网站及其官方发布的《Introducing System One Models & Jev》。
其中,“193.6 倍更快、444.6 倍更便宜”并不代表 Jev 在所有任务上都比 GPT 或其他大模型快 193.6 倍、便宜 444.6 倍。 该数据来自 TypeSafe 自建的 Workflow Evals,针对的是适合被拆解成多个结构化概率决策的 System One 类型工作流。
TypeSafe 官方同时说明,这组结果属于其预期真实场景收益中偏高的一端(higher end of real-world gains),且相关 Workflow 由其内部模型能力团队设计,因此可能存在一定测试偏差。
官网首页还展示了一次具体运行示例:Jev 的运行成本约为 0.000081 美元、耗时 0.114 秒;对比的 LLM 工作流约为 0.01388 美元、耗时 8.566 秒。该示例与“193.6x / 444.6x”并非同一组计算结果,不应直接互相换算。
另外,TypeSafe 所称的 Zero Hallucinations,主要指 Jev 的输出受到预定义 Schema 和类型约束,不会生成 Schema 之外的结果,并不意味着 Jev 的判断永远正确。
本文关于 Decision Model、Reasoning Model 的分工,以及未来 Intelligence Stack 的讨论,为基于 TypeSafe 公开资料所做的个人分析和推演,并非 TypeSafe 官方结论。
参考资料:
TypeSafe AI 官网 https://typesafe.ai/
TypeSafe AI:Introducing System One Models & Jev https://typesafe.ai/blog/introducing-system-one-models-and-jev